Искусственный интеллект оказался дороже для носителей некоторых языков: разница достигает 17 раз
- AlexT
- 28-окт-2026, 11:00
- 0 комментариев
- 1 просмотров
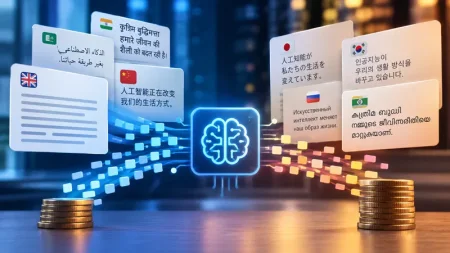
Использование искусственного интеллекта может обходиться значительно дороже людям, которые общаются с нейросетями не на английском языке. Исследователи обнаружили, что при обработке одинаковых по смыслу текстов языковые модели расходуют разное количество токенов. В отдельных случаях разница достигает 17 раз, что напрямую влияет на стоимость работы с коммерческими ИИ-сервисами и создаёт новую форму цифрового неравенства.
Проблема затрагивает не только финансовую сторону. Пользователи некоторых языков быстрее расходуют доступный контекст модели, сталкиваются с дополнительными вычислительными затратами и потенциально более длительным ожиданием ответов. Особенно заметны различия для языков с письменностью, которая недостаточно представлена в данных, использованных при создании ИИ-систем. Специалисты считают, что устранение этого дисбаланса должно стать одной из задач дальнейшего развития многоязычных нейросетей.
Причина различий связана с особенностями токенизации — процесса, при котором текст преобразуется в небольшие фрагменты, понятные языковой модели.
Такие фрагменты называются токенами. Один токен может представлять целое слово, его часть, отдельный символ или последовательность символов.
Большинство коммерческих ИИ-платформ рассчитывают стоимость обработки запросов исходя из количества входных и выходных токенов.
Поэтому текст, который алгоритм разделяет на большее число элементов, требует дополнительных ресурсов и при одинаковых тарифах обходится дороже.
Исследователи из Коалиции за языковое равенство в исследованиях ИИ (CLEAR) называют это явление «налогом токенизатора». Речь идёт не о реальном налоге, а о скрытых дополнительных расходах, возникающих из-за особенностей обработки разных языков.
Для оценки масштабов проблемы специалисты использовали международный набор текстов FLORES-200, содержащий параллельные переводы предложений примерно на 200 языков.
Исследователи сравнивали, сколько токенов требуется различным моделям для обработки текстов с одинаковым содержанием.
Среди 20 наиболее распространённых в интернете языков разница между наиболее экономными и затратными вариантами составляла от 1,5 до 5 раз в зависимости от используемой модели.
При расширении исследования до 200 языков максимальный разрыв для отдельных систем достигал 17 раз.
Например, одна и та же фраза на английском языке и малаялам, распространённом на юге Индии, в приведённом исследователями примере занимала соответственно 13 и 26 токенов.
При этом специалисты подчёркивают, что универсального коэффициента удорожания не существует. Результат зависит от конкретного текста, языка и алгоритма токенизации.
Дополнительное количество токенов создаёт ещё одну проблему, которая в некоторых сценариях может оказаться важнее стоимости запросов.
Каждая языковая модель имеет ограниченное контекстное окно — максимальный объём информации, который она способна учитывать при обработке запроса.
В этот объём входят сообщения пользователя, предыдущая переписка, загруженные документы и другие данные.
Если текст на определённом языке требует в несколько раз больше токенов, он быстрее заполняет доступный контекст.
В результате пользователю остаётся меньше места для длинных документов, сложных инструкций и продолжительных диалогов.
Кроме того, увеличение числа токенов повышает вычислительную нагрузку и может увеличивать задержку ответа.
Особенно заметные различия исследователи обнаружили среди языков, письменность которых сравнительно редко встречается в данных, применяемых при обучении токенизаторов.
К таким языкам относятся бирманский, тибетский, кхмерский и лаосский. Проблемы также наблюдаются при работе с письменностями тифинаг и ол-чики.
Однако распространённость языка не является единственным определяющим фактором.
Например, астурийский язык может обрабатываться сравнительно эффективно благодаря использованию латинского алфавита и сходству с другими романскими языками.
Таким образом, многое зависит от того, насколько хорошо конкретная письменность и характерные последовательности символов представлены в алгоритмах обработки текста.
Специалисты считают, что для решения проблемы недостаточно просто увеличивать объём обучающих данных.
Необходимо также совершенствовать сами алгоритмы токенизации, чтобы они эффективнее работали с различными системами письменности.
Одним из важных направлений становится использование качественных многоязычных наборов данных, позволяющих учитывать особенности языков, которые сегодня получают меньше внимания при разработке ИИ.
При этом универсальные токенизаторы должны обеспечивать более равномерную эффективность обработки текста, независимо от того, насколько распространён конкретный язык в интернете.
По мере распространения искусственного интеллекта языковое неравенство становится всё более заметной технической и экономической проблемой.
Даже если стоимость обработки токенов продолжит снижаться, различия в доступном контексте и вычислительных затратах сохранят своё значение.
Результаты исследования показывают, что развитие многоязычного ИИ требует внимания не только к качеству переводов и точности ответов, но и к эффективности обработки разных языков.
В перспективе совершенствование токенизаторов может сделать интеллектуальные сервисы доступнее для миллионов пользователей, которые предпочитают общаться с технологиями на родном языке.
Самый настоящий сургутский лисенок. Я аватар компании ИТ-Телеком и тут я хочу делиться с вами интересными новостями.
Apple выпустила обновление iOS 18.7: стабильная альтернатива новой iOS 26
16-сен-2025, 07:00