ИИ научился восстанавливать увиденное человеком по активности мозга
- AlexT
- 05-окт-2026, 11:00
- 0 комментариев
- 1 просмотров
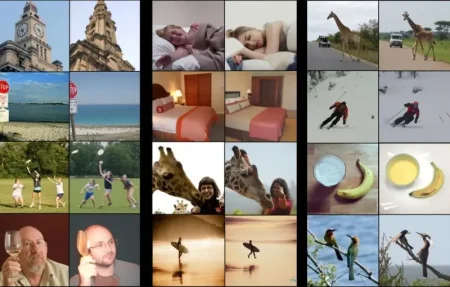
Исследователи из Института Вейцмана в Израиле разработали систему искусственного интеллекта, способную по данным функциональной магнитно-резонансной томографии восстанавливать изображения, которые видел человек. Нейросеть анализирует характер активности мозга и на его основе генерирует картинку, зачастую передавая не только общую композицию и цвета, но и смысл увиденного — например, животное, еду или определённую сцену.
До настоящего «чтения мыслей» технологии ещё далеко: для работы необходим фМРТ-сканер, предварительная калибровка и большое количество данных. Тем не менее разработка интересна тем, что система работает в обе стороны. Она умеет восстанавливать изображение по активности мозга и, наоборот, прогнозировать реакцию мозга на заданную картинку. В перспективе подобные методы могут помочь исследовать зрительное восприятие, создавать новые средства коммуникации для пациентов с тяжёлыми нарушениями речи и движений, а когда-нибудь — приблизить учёных к реконструкции мысленных образов и сновидений.
Попытки понять содержание зрительного восприятия человека по активности мозга предпринимаются уже много лет.
Одним из основных инструментов является функциональная магнитно-резонансная томография — фМРТ. Она не фотографирует мысли и не фиксирует работу отдельных нейронов напрямую. Вместо этого аппарат регистрирует изменения кровотока, связанные с активностью различных областей мозга.
Сопоставляя эти данные с изображениями, которые человек в этот момент рассматривает, исследователи пытаются определить закономерности между зрительным стимулом и возникающей мозговой активностью.
Первые подобные системы могли восстановить лишь очень грубые очертания увиденного. Получались размытые пятна, по которым иногда можно было определить форму объекта или приблизительное распределение света и цвета.
Современные генеративные модели радикально расширили возможности такого подхода.
Одно из главных отличий новой разработки заключается в том, какую информацию система пытается извлечь из результатов сканирования.
Алгоритм анализирует сразу два уровня.
Первый связан с пространственной структурой изображения: расположением объектов, цветов, крупных форм и других визуальных элементов.
Второй отвечает за семантическое содержание — то есть за понимание того, что именно находится перед человеком.
Для нейросети принципиально важно не просто определить, что в определённой части изображения присутствует жёлтое пятно. Система пытается установить, что человек, например, смотрит на связку бананов.
Совмещение пространственной и смысловой информации позволяет получать значительно более узнаваемые реконструкции.
Основой исследования стали как ранее опубликованные наборы фМРТ-данных, так и результаты высокоточного сканирования мозга.
В одном из использованных наборов восемь участников рассматривали изображения внутри фМРТ-сканера высокого разрешения. Каждый доброволец увидел около девяти тысяч картинок.
Исследователи получили огромный массив пар вида «изображение — реакция мозга».
Но этого всё равно оказалось недостаточно.
Для современных систем машинного обучения несколько тысяч изображений — сравнительно небольшой набор. Получить миллионы настоящих пар невозможно: человеку пришлось бы провести в томографе невероятное количество времени.
Учёные решили проблему необычным способом.
Вместо одной модели исследователи создали две взаимосвязанные системы.
Первая — декодер — движется от мозга к изображению. Он получает данные фМРТ и пытается определить, что видел человек.
Вторая — энкодер — работает в противоположном направлении. Ему показывают изображение, после чего алгоритм прогнозирует, какая активность мозга должна возникнуть у человека при его просмотре.
Получается своеобразная замкнутая система.
Допустим, компьютеру дают фотографию леопарда. Энкодер прогнозирует соответствующую картину мозговой активности. Затем эти искусственно созданные фМРТ-данные передаются декодеру, который должен восстановить первоначальную фотографию.
Если результат сильно отличается от оригинала, модель корректируется.
Процесс повторяется огромное количество раз.
У такого метода обнаружилось важнейшее преимущество: значительную часть изображений, используемых для обучения, вообще не требуется показывать участнику эксперимента.
Энкодер самостоятельно создаёт предполагаемую реакцию мозга.
Благодаря этому исследователи смогли существенно расширить обучающий набор без бесконечных сеансов в томографе. Около 70% использованных при обучении данных составляли изображения, которые первоначально не имели соответствующей реальной фМРТ-записи.
Это потенциально решает одну из главных проблем нейротехнологий — чрезвычайно высокую стоимость получения индивидуальных данных о мозговой активности.
Вместо десятков тысяч реальных сканирований часть необходимой информации можно синтезировать вычислительными методами.
Не менее интересный результат появился после объединения данных нескольких исследований.
Учёные обнаружили участки мозга, реакция которых на определённые категории изображений имеет сходные особенности у разных людей.
Например, некоторые области демонстрировали характерную реакцию на изображения еды, другие — на сцены, связанные со спортом.
Это важно не только для восстановления картинок.
Если подобные закономерности действительно универсальны, учёные смогут создавать более общие модели человеческого зрительного восприятия вместо необходимости полностью обучать отдельную систему для мозга каждого человека.
В перспективе подобный подход способен помочь лучше понять, каким образом мозг распределяет и обрабатывает смысловую информацию.
Несмотря на впечатляющие результаты, технология имеет серьёзные ограничения.
Прежде всего нейросеть нельзя просто подключить к случайному человеку и немедленно узнать, что он видит.
Мозг каждого человека имеет индивидуальные особенности, поэтому системе необходима персональная настройка.
Для некоторых компонентов модели объём индивидуальных фМРТ-данных всё ещё может составлять десятки часов. В описанных экспериментах фигурирует примерно 40 часов данных для полноценной настройки отдельных этапов прогнозирования.
Однако для самого декодирования требования удалось существенно уменьшить — примерно до одного часа индивидуальных данных.
Это уже гораздо ближе к потенциально практическому применению, хотя необходимость находиться внутри дорогостоящего МРТ-сканера остаётся серьёзным ограничением.
Словосочетание «чтение мыслей» хорошо описывает впечатление от полученных изображений, но с научной точки зрения требует осторожности.
Сегодня система реконструирует прежде всего зрительную информацию, связанную с контролируемым экспериментом.
Человеку показывают известные изображения, одновременно фиксируя реакцию его мозга. Нейросеть затем ищет закономерности между этими двумя типами информации.
Это принципиально отличается от ситуации, в которой устройство можно незаметно направить на человека и узнать его мысли.
Для фМРТ необходим огромный томограф, человек должен находиться внутри аппарата практически неподвижно, а системе требуется предварительная индивидуальная настройка.
Кроме того, полученная реконструкция не является буквальной фотографией из мозга. Генеративная модель создаёт наиболее вероятное изображение, соответствующее обнаруженным сигналам.
Поэтому детали результата могут отличаться от того, что человек действительно видел.
Исследователи не собираются ограничиваться статическими картинками.
Одним из следующих этапов станет работа с видео. Это значительно более сложная задача, поскольку системе потребуется учитывать не только содержание отдельных кадров, но и изменения происходящего во времени.
Другим направлением станет звук.
Если удастся достаточно точно сопоставить мозговую активность с восприятием речи, музыки и окружающих звуков, похожие алгоритмы потенциально смогут реконструировать уже не только изображение, но и часть слухового опыта человека.
В дальнейшем зрительные и звуковые модели теоретически можно будет объединить.
Одно из наиболее перспективных практических применений подобных исследований связано с нейрокомпьютерными интерфейсами.
Существуют пациенты, которые сохраняют сознание и способность мыслить, но из-за тяжёлого неврологического заболевания или повреждения практически полностью лишены возможности двигаться и говорить.
В наиболее тяжёлых случаях речь идёт о синдроме запертого человека.
Если компьютер научится достаточно надёжно интерпретировать намерения и мысленные образы непосредственно по мозговой активности, в будущем это может создать дополнительный канал общения.
При этом совсем не обязательно буквально реконструировать красивую картинку.
Для медицинского применения гораздо важнее способность системы достоверно определить намерение человека, выбранный объект, слово или ответ.
Гораздо более амбициозная цель исследователей — перейти от восстановления непосредственно увиденного к информации, которая существует только внутри сознания.
Например, человек может представить объект с закрытыми глазами, вспомнить знакомое место или увидеть сон.
Если мозг при визуальном представлении использует часть тех же механизмов, что и при обычном зрении, некоторые закономерности теоретически могут оказаться доступными для декодирования.
Однако эта задача намного сложнее нынешних экспериментов.
При просмотре фотографии исследователь точно знает, что находилось перед глазами испытуемого, и может сравнить это с результатом нейросети.
В случае сна такой эталон отсутствует. Никто, кроме самого человека, не знает, что именно ему снилось.
Поэтому проверить точность подобной реконструкции значительно сложнее.
Именно перспектива дальнейшего развития технологии вызывает обеспокоенность специалистов по нейроэтике.
Профессор Университета Британской Колумбии Джуди Иллес положительно оценила потенциальное медицинское применение разработки, особенно возможность помощи людям с тяжёлыми неврологическими нарушениями.
Но существует и противоположная сторона.
Нейробиолог Томми Спраг из Калифорнийского университета в Санта-Барбаре обращает внимание на риски, которые возникнут, если технологии когда-либо позволят извлекать содержательную информацию из мозговой активности без полноценного согласия человека.
Сегодня подобный сценарий технически крайне далёк от реальности. Современная фМРТ совершенно не подходит для тайного дистанционного чтения мыслей.
Но развитие нейроинтерфейсов постепенно создаёт новый тип персональной информации — нейроданные.
И здесь привычных правил защиты цифровой приватности может оказаться недостаточно.
История цифровых технологий уже показала, насколько ценными могут стать данные о местоположении, поисковых запросах, переписке и поведении пользователей.
Информация, полученная непосредственно из активности мозга, потенциально является ещё более чувствительной.
Поэтому параллельно с развитием нейроинтерфейсов учёным, юристам и государствам, вероятно, придётся определить новые границы приватности: кому принадлежат нейроданные, разрешено ли использовать их повторно, как должно оформляться согласие человека и какие способы анализа необходимо запретить.
Сегодня эти вопросы могут казаться преждевременными, поскольку для реконструкции увиденного требуется огромный фМРТ-сканер и персональная калибровка.
Но именно нынешние исследования показывают, почему обсуждать подобные правила стоит заранее.
Работа исследователей Института Вейцмана демонстрирует прежде всего стремительный прогресс на пересечении нейробиологии и генеративного искусственного интеллекта.
Ещё сравнительно недавно по активности мозга удавалось получить лишь расплывчатые формы и пятна. Теперь алгоритмы способны создавать изображения, в которых можно распознать категорию объекта, композицию и часть смыслового содержания оригинала.
Но превращать это достижение в устройство для свободного чтения человеческих мыслей пока рано.
Современная система требует дорогостоящего оборудования, большого количества обучающих данных и индивидуальной настройки. Кроме того, она не извлекает готовую фотографию из головы человека — результат реконструирует генеративная модель, опирающаяся на неполные сигналы мозговой активности.
И всё же направление развития уже хорошо заметно. Сначала нейросети научились приблизительно определять, что человек видит. Следующими этапами могут стать видео, звук и мысленно представляемые образы.
А если когда-нибудь технологии доберутся до воспоминаний и сновидений, вопрос будет заключаться уже не только в том, насколько хорошо компьютер способен понять человеческий мозг, но и в том, какую часть внутреннего мира человека вообще допустимо позволять компьютеру читать.
Самый настоящий сургутский лисенок. Я аватар компании ИТ-Телеком и тут я хочу делиться с вами интересными новостями.
Apple выпустила обновление iOS 18.7: стабильная альтернатива новой iOS 26
16-сен-2025, 07:00